微软发布第三代自研AI芯片Maia 300 每兆瓦算力效率提升40%
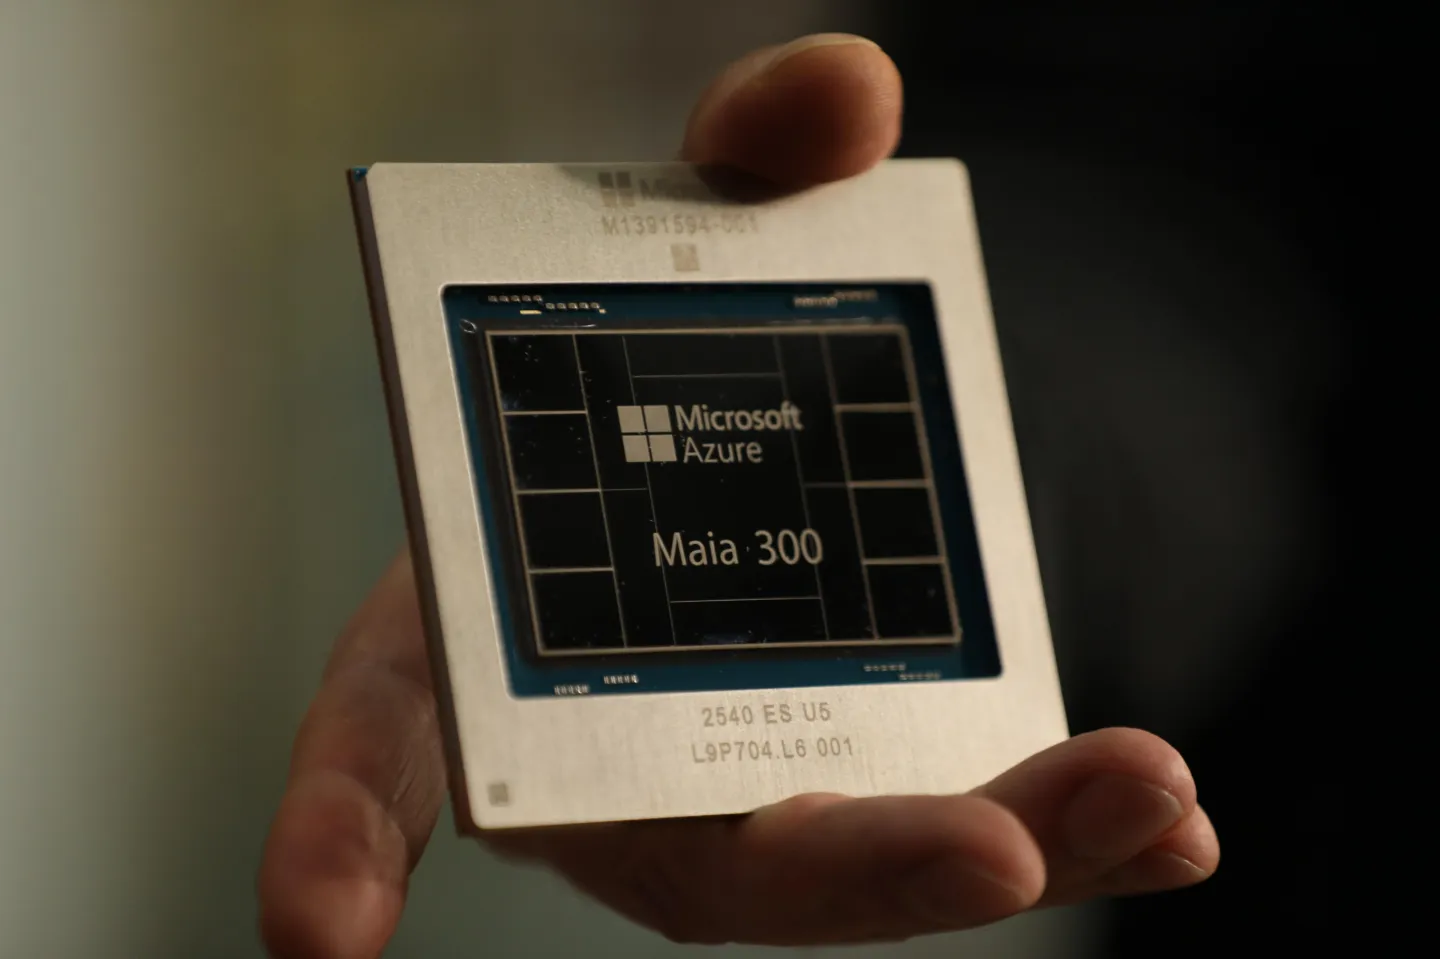
微软正式公布第三代自研人工智能芯片Maia 300,计划从2027年开始将其部署到生产环境,用于支持Copilot等产品和服务背后的AI推理任务。微软表示,与当前领先的GPU系统相比,Maia 300预计每兆瓦电力能够处理多出40%的Token;在由96颗加速器组成的完整机架配置中,其机架级Token吞吐量最高可达到上一代Maia 200的7倍。
此次发布标志着微软进一步加大对自研AI芯片的投入。随着人工智能服务的使用量不断增长,微软希望通过自主设计的加速器降低运行成本、提高能源利用效率,并减少对英伟达和AMD等供应商GPU的依赖。
微软云计算业务执行副总裁斯科特·格思里(Scott Guthrie)表示,公司计划从2027年开始,将Azure Maia系列芯片的部署规模扩大至多吉瓦级别,并使其成为微软产品和服务的主要AI推理系统。
这一目标意味着,微软希望将自研芯片从现有基础设施中的一部分,逐步提升为支撑自身AI服务的核心计算平台。不过,这并不意味着微软将完全停止采购英伟达或AMD的GPU。对于需要不同计算能力的训练和推理任务,微软仍可能继续采用多种硬件平台。
Maia 300是微软Maia系列的第三代产品,也是继今年1月公布Maia 200之后推出的新一代芯片。Maia 200目前已经用于微软多个生产环境中的AI工作负载,包括Microsoft Copilot、GitHub Copilot、Microsoft Foundry以及微软自研的人工智能模型。
格思里表示,从实际AI服务的运行指标来看,Maia 200已经是微软内部表现最出色的AI基础设施之一。新一代Maia 300则针对不断变化的AI工作负载进行了专门设计,尤其是需要处理长上下文推理、对延迟高度敏感的实时对话,以及持续执行多个步骤的AI代理任务。
这些应用对硬件提出了不同于传统AI推理的要求。
随着大型语言模型逐渐应用于编程助手、企业自动化和复杂任务执行,AI系统需要处理的上下文越来越长,单次任务涉及的模型调用和工具操作也越来越多。对于云服务提供商而言,除了模型本身的性能,还必须考虑响应延迟、并发请求数量、内存容量以及每次推理的实际成本。
因此,Maia 300的设计重点并不只是提高峰值计算能力,还包括在持续运行的真实业务环境中提高整体效率。微软希望通过专门优化芯片架构,使其更适合处理新一代推理模型和AI代理产生的计算负载。
在芯片制造方面,Maia 300采用台积电N2P先进制程,并引入芯粒化设计架构。与将不同功能全部集成在单一大型芯片上的传统设计相比,芯粒架构可以将计算、内存控制器和输入输出等功能划分为不同模块,再根据各自的特点进行设计。
微软Azure硬件与基础设施团队表示,这种设计能够让芯片中更多的硅面积用于计算性能,同时使不同功能模块采用更适合自身需求的技术。
这一思路具有现实意义。对于AI加速器而言,计算单元固然重要,但数据如何在计算单元、内存和外部设备之间传输,同样会影响整体性能。如果计算单元需要等待数据到达,即使拥有很高的理论算力,也无法充分发挥性能。
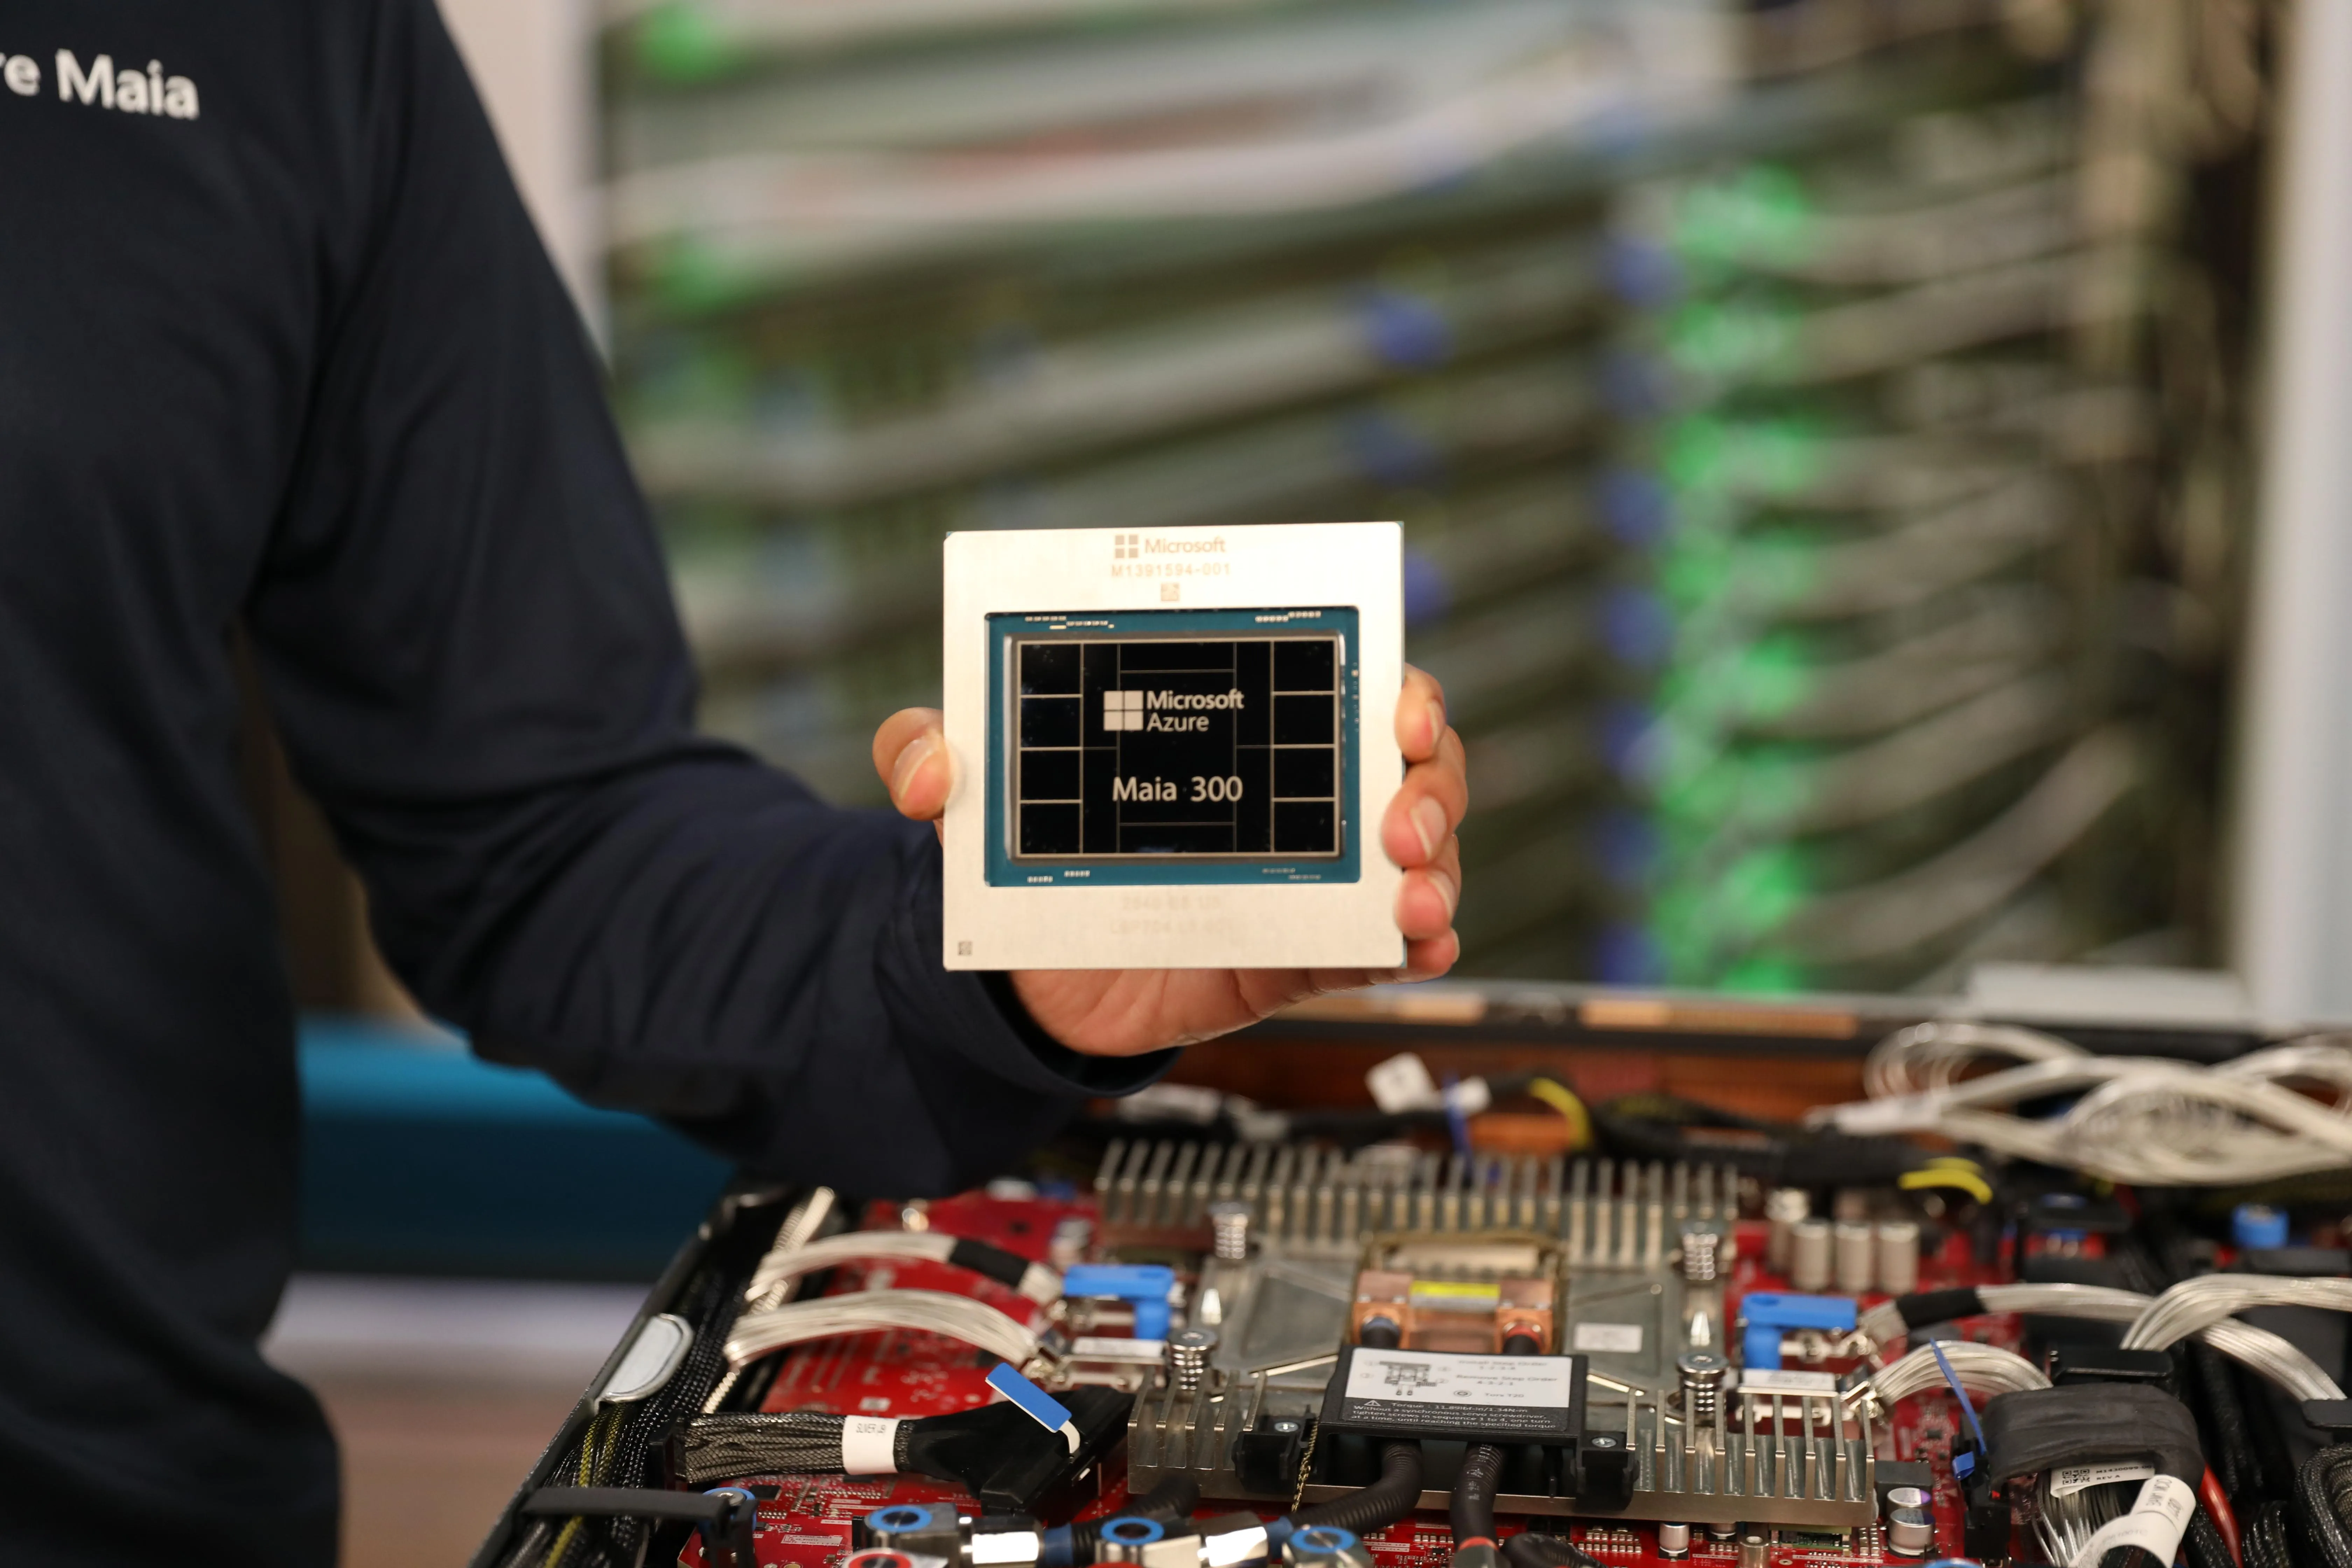
通过将计算、内存控制和输入输出功能分别进行优化,微软希望改善芯片的整体资源利用效率,并在性能、功耗和制造成本之间取得更好的平衡。
采用先进制程也有助于提高晶体管密度和能效,但芯片最终表现仍取决于微架构、内存子系统、互连设计以及软件优化等多个因素。Maia 300公布的性能数据目前主要来自微软自身的介绍,实际效果仍需要结合不同模型、工作负载和部署条件进行评估。
在AI推理领域,Token吞吐量是衡量系统效率的重要指标之一。Token是大型语言模型处理文本时使用的基本数据单位,通常对应一个词语、词语片段或其他文本单元。系统在单位时间内能够处理多少Token,直接影响其同时服务多少用户,以及完成任务所需的计算资源。
微软预计,Maia 300每兆瓦能够处理的Token数量将比领先GPU系统高出40%。这意味着,在相同电力预算下,微软有望处理更多AI请求,或者在提供相同服务能力的情况下减少电力消耗。
对于拥有大规模数据中心的云服务商而言,这种效率提升可能带来显著的经济价值。AI数据中心不仅需要购买昂贵的加速器,还必须承担供电、散热、网络设备和基础设施建设等成本。随着模型使用量持续增长,电力供应和数据中心容量正在成为制约AI服务扩张的重要因素。
不过,每兆瓦Token效率并不是衡量AI芯片的唯一指标。不同模型的参数规模、上下文长度、精度设置和推理方式都会影响测试结果。要全面比较Maia 300与英伟达GPU等产品,还需要考虑延迟、模型兼容性、软件生态、部署成本以及实际业务中的稳定性。
微软还公布了一项更具吸引力的指标:在由96颗加速器构成的完整机架配置中,Maia 300的机架级Token吞吐量最高可达到Maia 200的7倍。
这一数字显示,微软不仅希望提高单颗芯片的效率,也在针对整个机架的计算能力进行优化。但它描述的是特定配置下的机架级吞吐量,并不意味着Maia 300在所有任务中都比Maia 200快7倍,更不能直接推导出每颗芯片的性能提高了相同比例。
对于云计算平台而言,机架级性能尤其重要。实际部署通常由大量加速器组成,芯片之间需要通过高速互连交换数据,并共同处理模型请求。即使单颗芯片性能很强,如果互连带宽、内存容量或调度效率不足,整个系统仍可能受到限制。
因此,微软正在尝试从芯片设计、机架配置到软件和模型运行环境进行整体优化,而不是单纯追求处理器的理论算力。
微软AI负责人穆斯塔法·苏莱曼(Mustafa Suleyman)表示,公司必须从整个技术栈的底层开始投入,包括芯片设计。他认为,当AI服务达到如此庞大的规模时,微软需要拥有自己的平台,并让芯片与自研模型共同设计和优化。
他特别强调,让微软自研AI模型运行在Maia芯片之上,是微软AI团队的一项重要工作。
这一表态揭示了微软发展自研芯片的另一个目标:将硬件、模型和云服务结合起来,形成更紧密的协同关系。
传统云服务商可以通过采购通用GPU来部署AI模型,但如果能够自主设计加速器,就可以针对自身模型的计算特点、内存需求和推理流程进行优化。反过来,模型团队也可以根据芯片架构调整模型结构和运行方式,从而提高整体效率。
Google和亚马逊已经在自研AI芯片领域投入多年。Google拥有TPU系列加速器,亚马逊则开发了Trainium等芯片,用于支持自家的云计算和人工智能服务。微软推出Maia系列,也是在这一竞争背景下加强自身基础设施能力。
对于微软而言,自研芯片的战略价值不仅是降低采购成本,还包括提高供应链自主性、优化数据中心能源利用率,以及在AI模型和服务快速迭代时拥有更大的硬件设计控制权。
目前,微软仍然与英伟达保持密切合作,英伟达GPU继续在AI训练和推理领域发挥重要作用。微软同时发展Maia系列,并不意味着双方关系必然发生根本性变化,而是反映出大型云服务商正在通过自研芯片和多供应商策略,降低对单一硬件平台的依赖。
微软还希望借助自研芯片提升自身AI模型的竞争力。苏莱曼表示,Maia平台是微软AI技术体系的重要组成部分,能够帮助公司进一步发展自有模型,并在与Google DeepMind、OpenAI和Anthropic等竞争对手的较量中提高竞争力。
随着AI模型逐渐从简单的文本生成工具发展为能够调用工具、执行复杂操作的代理系统,硬件基础设施的重要性也在不断提高。长上下文推理和多步骤任务执行往往涉及更长时间的计算过程,以及大量模型调用。只有在性能、延迟和成本之间实现更好的平衡,企业才能以可持续的方式扩大服务规模。
Maia 300正是针对这一趋势进行设计。微软希望通过更高的吞吐量和能效,让更多AI任务能够以较低成本运行,同时为Copilot、GitHub Copilot以及未来的AI代理服务提供计算支持。
不过,Maia 300要真正成为微软AI基础设施的主力,仍需经历从芯片制造、系统集成到大规模部署的过程。微软计划在2027年开始将其投入生产环境,并逐步扩大部署规模。届时,芯片的实际产能、系统稳定性、软件适配程度以及与现有数据中心的整合效果,都将影响其最终应用范围。
总体来看,Maia 300的推出显示,微软正在将AI芯片从辅助性的基础设施项目提升为自身人工智能战略的核心组成部分。通过采用台积电先进制程、芯粒化设计以及面向推理工作负载的系统级优化,微软希望提高每单位电力所能提供的AI服务能力,并降低对外部GPU供应商的依赖。
如果微软能够在2027年按计划扩大Maia 300的生产部署,并在真实业务中实现预期的效率提升,这一系列芯片就有望成为其控制AI计算成本、扩大服务规模的重要工具。但其长期竞争力最终仍取决于实际运行表现,以及微软能否在硬件、模型和软件之间建立持续有效的协同优化体系。