英伟达与思科推出新一代高速光模块USFP 单通道速率达400Gbps
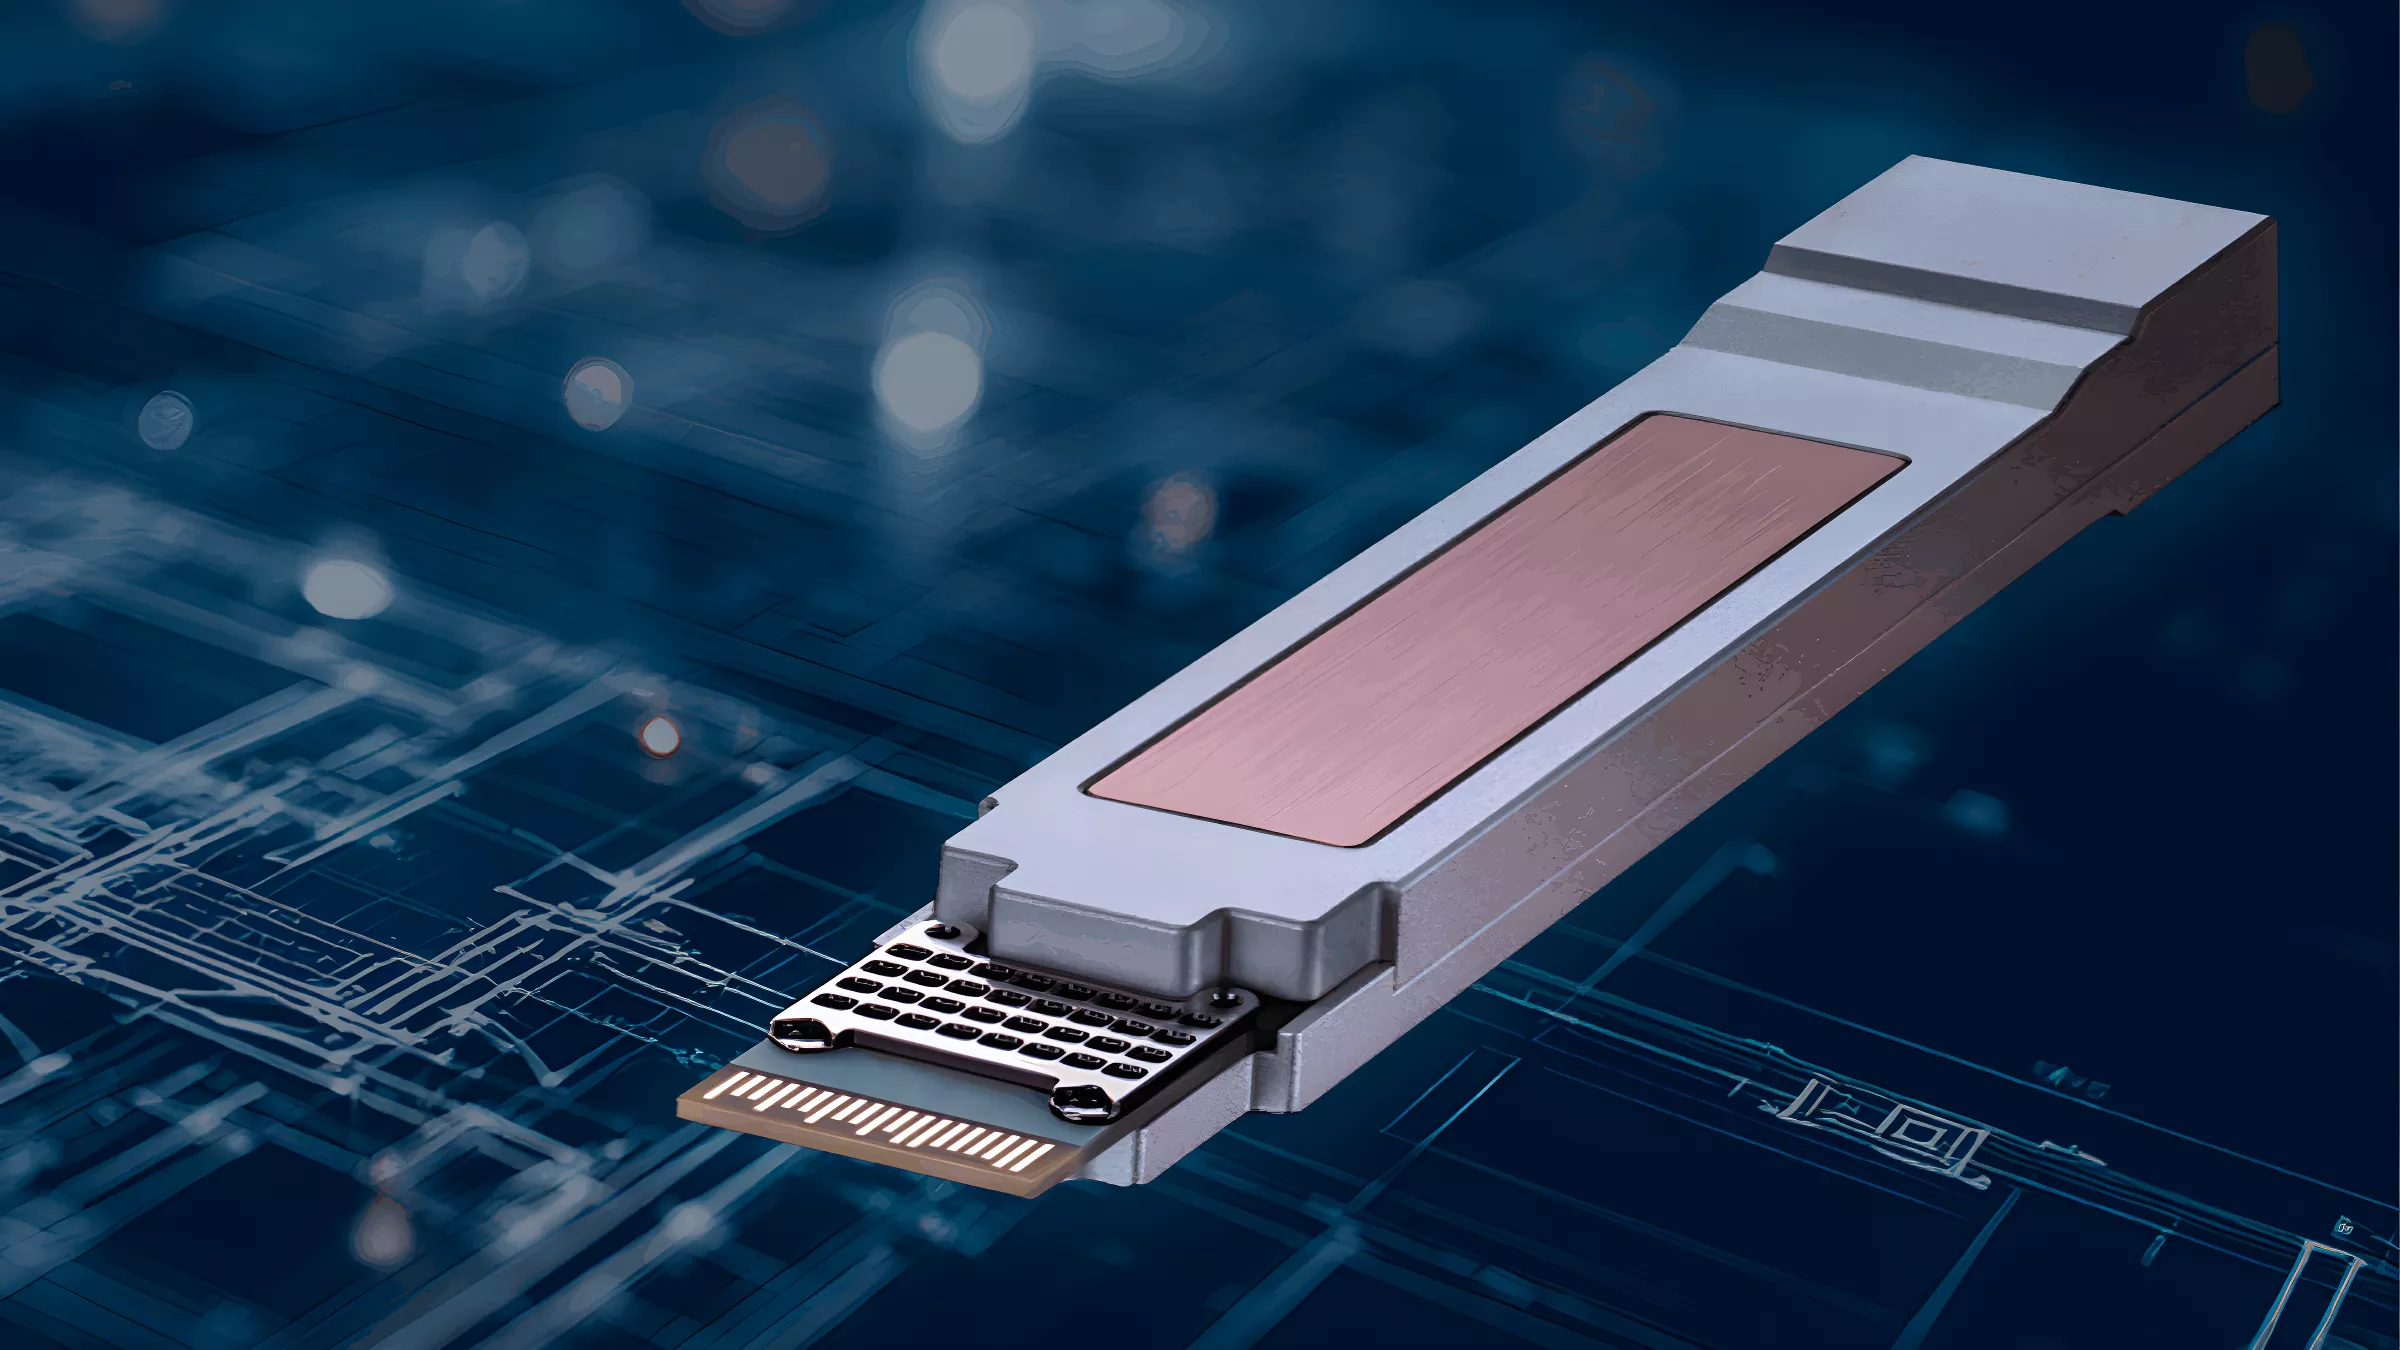
随着人工智能模型规模不断扩大,数据中心对网络带宽的需求正在快速增长。英伟达与思科于2026年10月12日宣布联合开发新一代高密度可插拔光模块Ultra-Dense Small Form Factor Pluggable(USFP),旨在提升AI数据中心内部的网络连接能力,在有限的设备空间内传输更多数据,同时降低网络通信的能耗。该技术未来的总带宽最高可达12.8Tbps,相比采用每通道200Gbps技术的现有光模块,带宽密度有望提高至四倍,能效则提升约30%。
这项技术于2026年开放计算项目(OCP)全球峰会期间公布。随着生成式人工智能从单一模型训练发展到大规模推理和多智能体协作,数据中心需要连接数量庞大的GPU、AI加速器、存储设备和网络交换机。不同计算节点之间必须持续交换大量数据,网络连接能力因此逐渐成为制约AI基础设施扩展的重要因素。
在传统数据中心中,当网络交换机的端口容量或带宽达到上限时,运营商往往需要增加交换机层级或部署更多网络设备。这不仅会提高设备采购和运维成本,还可能增加通信延迟、功耗和散热压力。英伟达与思科希望通过提高单个光模块能够承载的数据量,让数据中心在不大幅改变现有网络架构的情况下,连接更多计算设备。
USFP的核心特点是支持每通道400Gbps的电气信号传输能力。与目前采用每通道200Gbps技术的方案相比,这意味着单个通道的理论传输速率提高了一倍。通过增加通道数量,USFP能够进一步提升单个模块的总体带宽。
首批计划推出的USFP光收发模块将采用16条全双工通道,并使用与八通道小型可插拔模块OSFP相近的外形尺寸。按照每条通道400Gbps计算,16条通道的总容量为6.4Tbps。未来,设计方案计划扩展至32条甚至更多通道,从而将总容量提高至12.8Tbps。
需要注意的是,12.8Tbps是该技术未来规划达到的总容量,并不意味着首批产品已经具备这一完整性能。初期16通道方案对应的总带宽为6.4Tbps,后续仍需要完成相关技术开发和系统验证,才能实现32通道配置所对应的12.8Tbps容量。
在实际应用中,USFP不仅面向网络交换机,也计划支持英伟达及其合作伙伴开发的SuperNIC高速网络适配器。这类网络适配器专门针对AI计算集群设计,能够加速服务器与GPU之间的数据传输,并支持RDMA over Converged Ethernet(RoCE)等技术。
RoCE允许设备通过以太网实现远程直接内存访问,使数据能够在不同计算节点之间传输,而不必完全依赖传统网络协议栈进行处理。对于需要大量GPU协同训练的人工智能系统而言,这有助于减少通信开销,并提高集群中计算资源的利用效率。
USFP的设计重点不仅是提高带宽,还包括在高密度部署环境中控制能耗和散热。英伟达与思科表示,与每通道200Gbps的光模块方案相比,新技术的带宽密度可提高四倍,单位数据传输的能效则有望提升约30%。对于拥有数万甚至数十万颗GPU的大型AI数据中心而言,即使单个网络组件的能效有所改善,经过大规模部署后也可能带来可观的能源节省。
不过,网络设备的整体功耗并不会仅因为光模块的能效提高就按相同比例下降。实际结果还取决于交换机芯片、信号处理电路、光电转换组件、冷却系统以及网络拓扑结构。因此,USFP的能效优势仍需要结合完整设备和实际数据中心负载进行评估。
在机械结构方面,USFP采用两阶段插入设计,旨在改善电气接触的可靠性和信号完整性,并减少反复插拔造成的触点磨损。对于需要频繁维护和升级的数据中心而言,模块的可维护性同样重要,因为网络设备停机可能影响整个AI集群的运行。
思科还表示,USFP的设计目标之一,是在不需要为收发模块配置专用内部冷却回路的情况下,支持最高100瓦的功耗。这一能力对于高密度网络设备尤其重要,因为高速信号处理和光电转换通常会产生大量热量,而散热能力直接影响设备的稳定性和部署密度。
为了推动技术落地,英伟达和思科正在与TE Connectivity、Amphenol等企业合作,建立更完整的硬件供应链。这些合作伙伴将参与开发模块笼架、连接器及相关组件。两家公司希望通过多家供应商参与的方式,扩大USFP的产业生态,避免新接口完全依赖单一厂商提供所有零部件。
与此同时,USFP并不是要取代所有现有光通信技术。数据中心网络正在同时探索多种架构,包括可插拔光模块、近封装光学技术和共封装光学技术等。不同方案在带宽密度、能耗、散热、维护难度和成本方面各有取舍。USFP的主要优势在于延续成熟的可插拔模块部署方式,让数据中心运营商能够在保留现有维护模式的同时,逐步升级网络性能。
对于大型云服务商和AI基础设施运营商而言,这种兼容既有部署方式的设计具有现实意义。建设新一代AI数据中心通常涉及服务器、交换机、供电系统、冷却设施和网络布线等多个环节。如果每一次带宽升级都需要彻底更换整套基础设施,成本和实施难度将大幅增加。通过提高可插拔模块的容量,USFP希望让运营商在延续现有设备管理流程的同时,为下一代AI计算集群提供更高带宽。
英伟达近年来不断扩大在数据中心网络领域的布局。除了GPU和AI加速器,该公司还通过Spectrum系列交换机、ConnectX网络适配器以及Spectrum-X以太网平台,为AI集群提供从计算节点到网络基础设施的完整连接方案。思科则长期深耕企业网络、交换机和数据中心通信设备。双方此次合作,体现出AI基础设施竞争已经从单纯的处理器性能,延伸至网络带宽、数据传输效率和系统整体能效。
随着AI模型训练和推理规模持续扩大,网络不再只是连接服务器的辅助设备,而是影响整个计算系统性能的重要组成部分。即使GPU拥有很强的计算能力,如果不同设备之间无法及时交换数据,计算资源也可能因为等待通信而无法得到充分利用。因此,提高网络带宽、降低通信延迟和控制传输功耗,正在成为建设大规模AI数据中心的关键任务。
总体而言,USFP的主要价值在于为下一代AI数据中心提供更高密度的光连接方案。首批设计采用16条400Gbps全双工通道,理论总容量达到6.4Tbps,未来则计划扩展至32条通道,实现最高12.8Tbps的总带宽。与此同时,该技术试图在能效、散热和可维护性之间取得平衡,让运营商能够在不彻底改变现有部署模式的情况下扩展AI网络。
不过,USFP目前仍处于技术开发和生态建设阶段,未来性能、成本和实际部署规模仍有待进一步验证。它能否成为下一代AI数据中心的主流接口,还取决于后续产品成熟度、产业链支持程度以及大型云服务商的采用情况。可以确定的是,随着AI计算集群不断扩大,高速光互连将成为数据中心基础设施竞争中越来越重要的一环。