一项由开发者完成的实验显示,通过定制软件将iPhone 17 Pro Max与搭载M4 Pro芯片的MacBook Pro连接后,可以显著提升本地大语言模型的运行效率。在运行Qwen3.8-27B模型时,系统预填充(Prefill)性能最高提升达到44%。
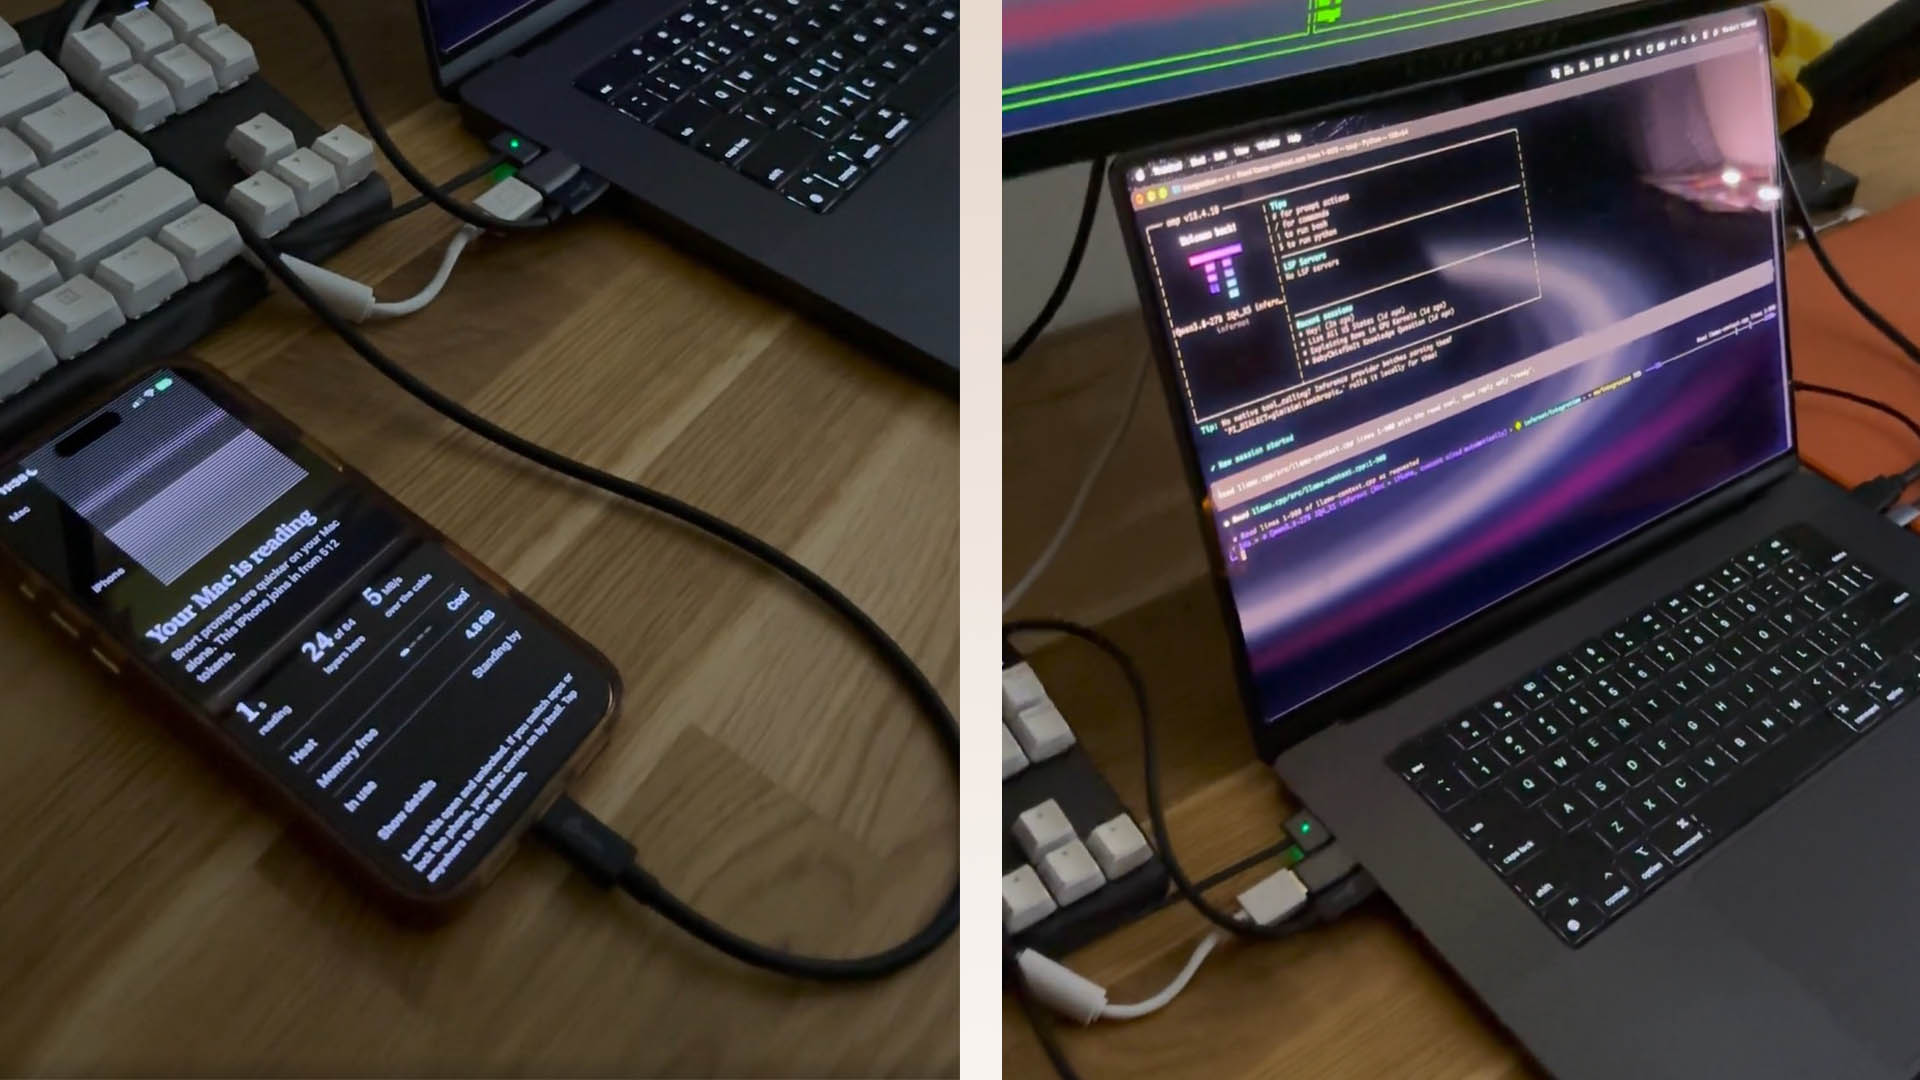
此次实验的背景是,大型语言模型对显存和系统内存容量要求极高。虽然搭载M4 Pro芯片的MacBook Pro拥有24GB统一内存,但在运行270亿参数级别的大模型时仍会受到内存容量和上下文窗口规模的限制。开发者因此尝试利用iPhone 17 Pro Max作为额外计算节点,通过USB-C接口与MacBook Pro协同运行模型。
根据开发者公布的方案,MacBook Pro负责处理每个256 Token批次中的第1层至第40层计算任务,并将中间激活数据实时传输至iPhone。随后,iPhone 17 Pro Max利用A19 Pro芯片中的GPU继续执行第41层至第64层运算,而Mac则同步开始处理下一批数据。通过这种流水线式分工,两台设备能够同时参与模型推理过程。
实验结果显示,相较于仅使用MacBook Pro运行模型,引入iPhone后预填充速度获得明显提升。在8K上下文窗口下,处理速度从每秒132个Token提高至177个Token,增幅达到35%;在16K上下文窗口下,性能从每秒109个Token提升至157个Token,增幅达到44%;在32K上下文窗口场景中,处理速度则从每秒101个Token提升至130个Token,增幅约29%。
除了GPU协同计算之外,A19 Pro芯片中的神经网络引擎也参与了部分任务。开发者表示,每16K历史上下文会被转换为专用神经网络模型进行处理。在14万Token上下文规模下,单Token写入时间从仅依赖GPU时的279毫秒缩短至176毫秒,进一步提升了长上下文场景下的运行效率。
不过,这一方案并非没有限制。开发者指出,iPhone主要帮助提升预填充阶段性能,而在64K以下文本生成任务中,大部分实际推理工作仍然主要由Mac完成。此外,该方案需要专门开发的软件支持,目前并不适用于普通用户直接部署。
尽管如此,这项实验展示了消费级苹果设备在本地人工智能计算方面的潜力。随着移动芯片性能持续提升,未来智能手机、平板电脑以及个人电脑之间或许能够形成更加灵活的协同计算体系,从而降低运行大型人工智能模型对单一设备硬件配置的依赖。