微软推出面向 Windows 11 的 RDMA over USB4 技术,让多台普通 PC 通过 USB4 或 Thunderbolt 连接协同工作,共享内存与 GPU 算力,从而运行原本超出单机内存容量的超大规模 AI 模型。该技术有望降低本地 AI 推理的硬件门槛,让开发者利用现有电脑组建分布式计算系统。
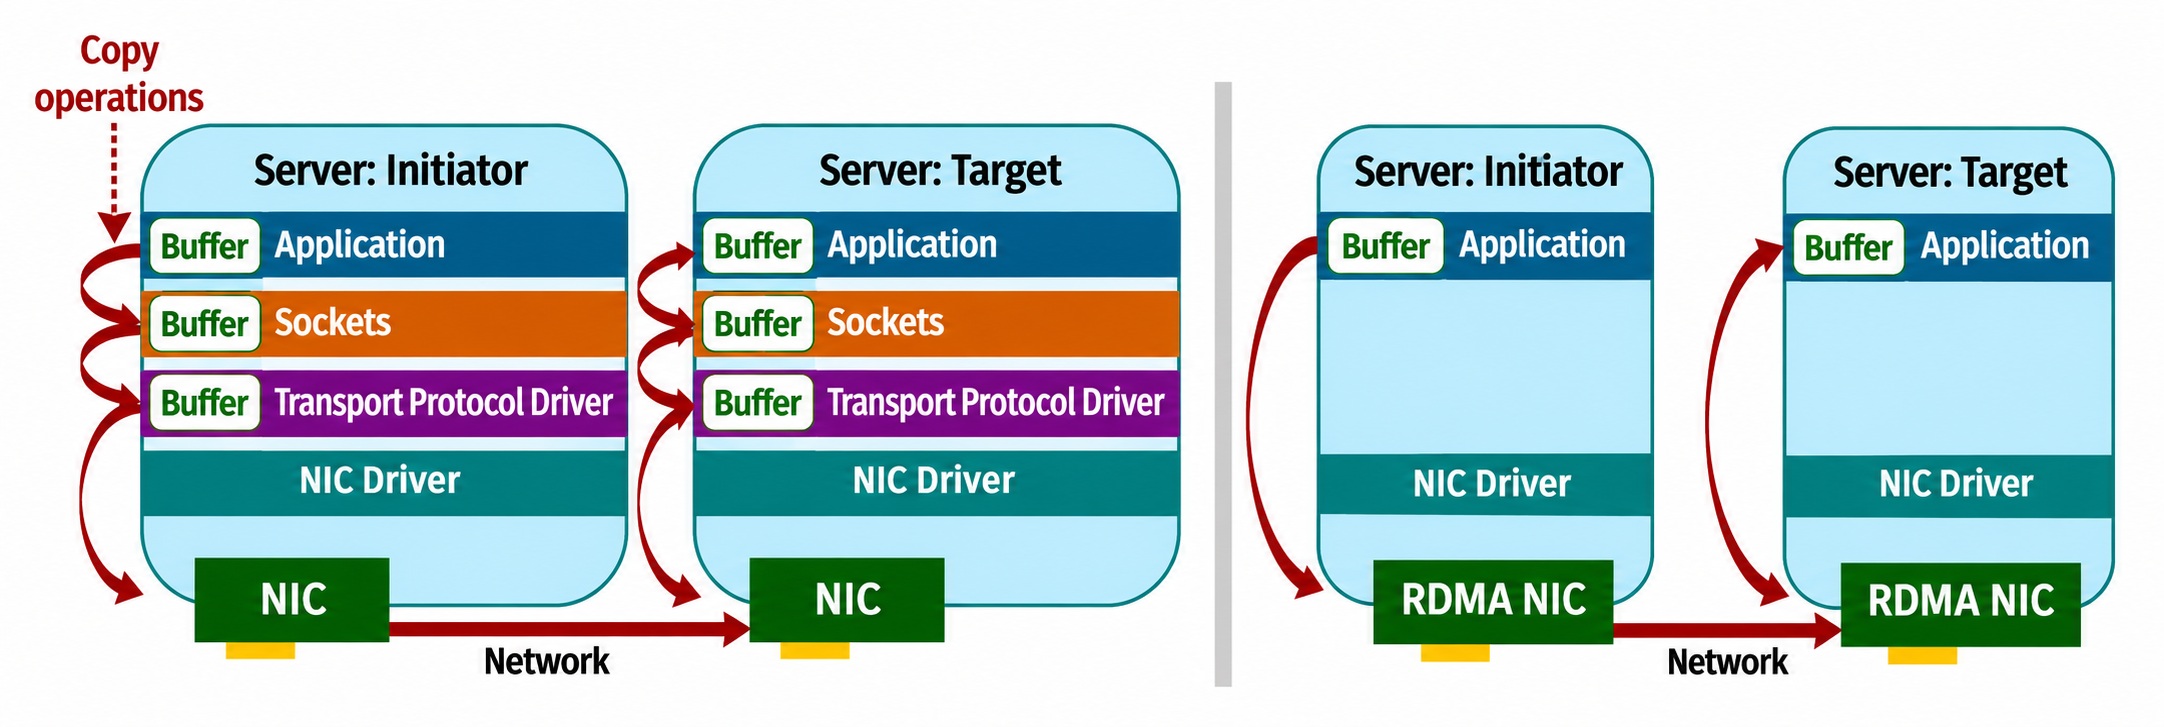
这项技术基于远程直接内存访问(RDMA)。与依赖 TCP/IP 的传统网络通信不同,RDMA 可让连接设备之间直接读写彼此内存,绕过操作系统和 CPU 的部分网络处理环节,从而减少数据复制、降低通信延迟并提高传输效率。RDMA 此前主要应用于高性能服务器和数据中心,微软此次则将其引入消费级 Windows PC。
微软表示,RDMA over USB4 借助现有的 NetworkDirect 接口和一款新的软件 RDMA 提供程序实现。兼容设备可通过 USB4 或受支持的 Thunderbolt 连接直接通信,无需专用 RDMA 网卡或网络交换机。测试显示,在传输小消息时,其往返延迟约为 28 至 50 微秒,较基于 UDP 的传统 Ethernet over USB4 通信降低约四倍。该低延迟在 40 Gbps 和 80 Gbps 连接下均能保持,尽管后者拥有两倍的标称带宽。
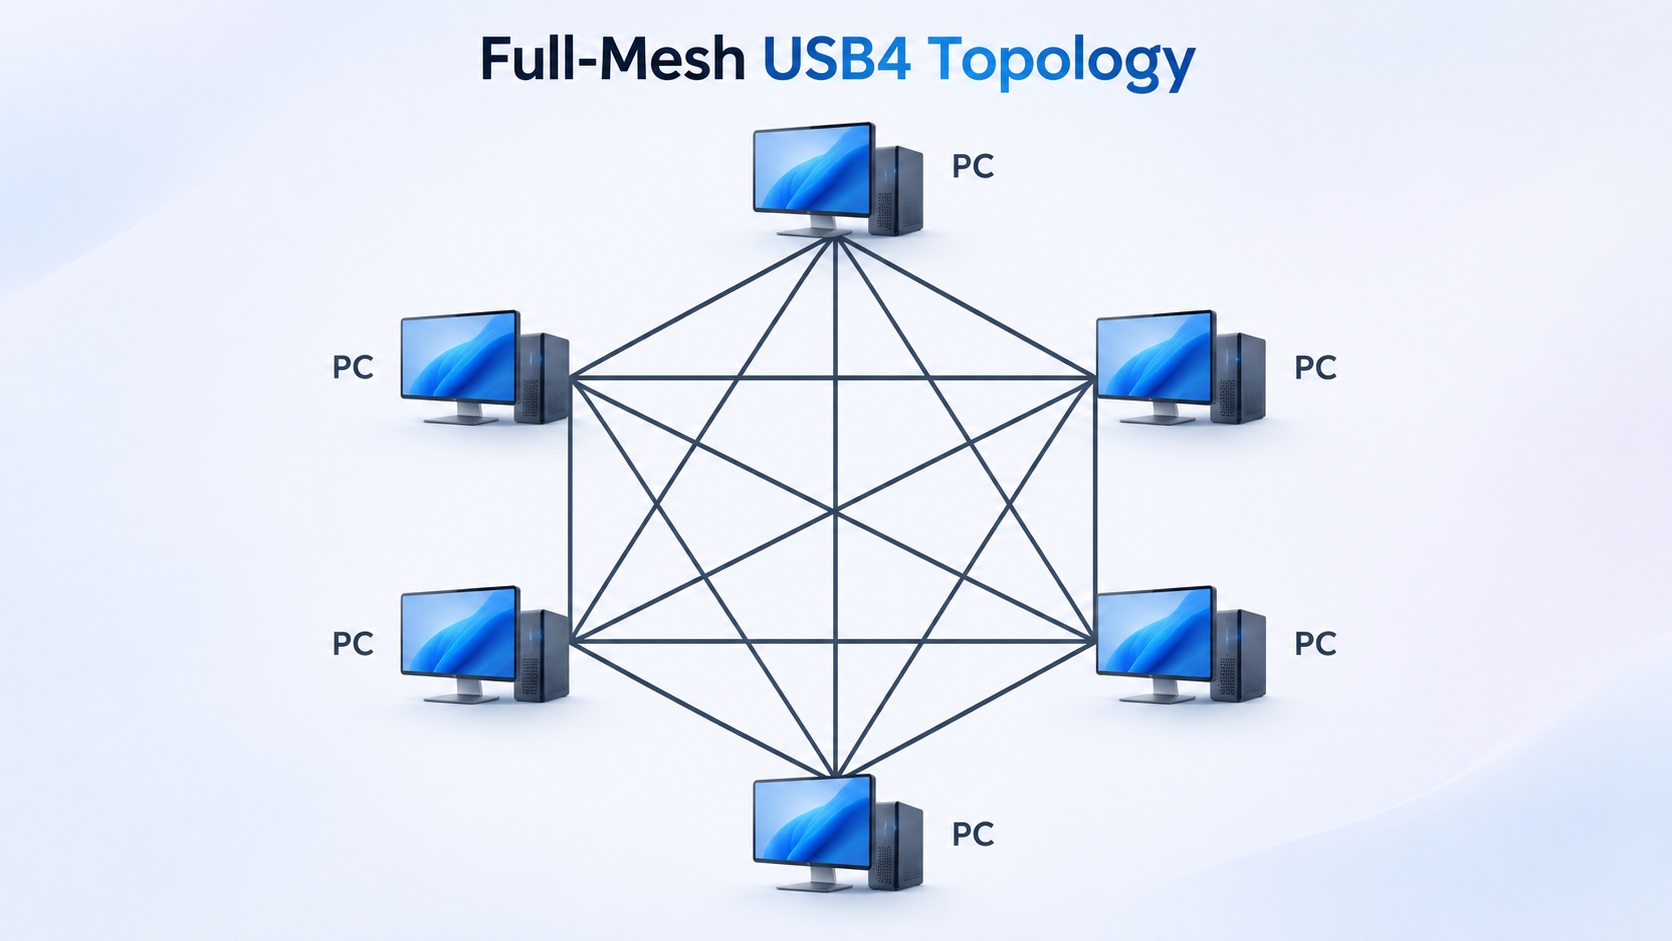
在实际演示中,微软与 AMD 合作,将三台搭载 Ryzen AI Max+ 395 处理器、Radeon 8060S 显卡及 128 GB 统一内存的迷你 PC,通过全互联 USB4 40 Gbps 网络连接。三台设备成功运行了拥有 2350 亿参数的 Qwen3-235B-A22B 混合专家模型,在 4 位量化下达到约每秒 18.5 个 token 的推理速度。AMD 的独立测试则显示,解码速度可达每秒 21.98 个 token,提示词处理速度达到每秒 117.98 个 token。
英特尔也进行了类似演示,使用三台和四台配备 Core Ultra Series 3 处理器、64 GB 内存及 Thunderbolt 4 连接的 PC 运行 GPT-OSS-120B 模型。在 1000 token 上下文长度下,三台设备的速度约为每秒 49.4 个 token,四台设备则提升至每秒 54.2 个 token。值得注意的是,这款 1200 亿参数的模型无法完整装入单台 64 GB 内存的 PC,因此多机协同成为运行该模型的关键。
微软指出,RDMA over USB4 目前仍处于实验阶段,对硬件和软件配置均有较高要求。参与测试的 PC 必须配备由 Windows 管理的 USB4 连接,最好达到 40 Gbps 或更高速度。微软还建议采用全互联拓扑,即每台 PC 都与其它设备直接连接,而不是采用菊花链式串联,因为后者可能显著降低性能。
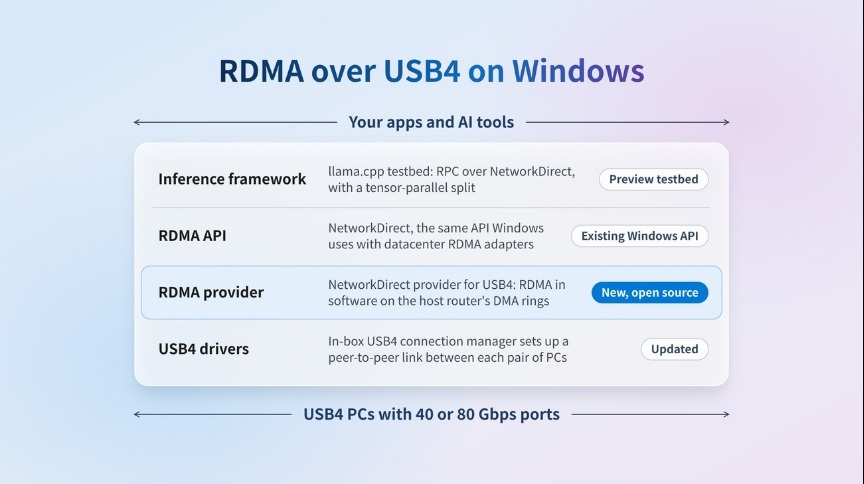
此外,应用程序必须通过兼容框架明确支持分布式执行。微软已开源 NetworkDirect 提供程序,并发布了经过修改的 llama.cpp 实现,用于展示该技术。RDMA over USB4 预计将随未来 Windows Insider 实验频道的“Future Platforms”版本推出,但微软尚未公布具体发布时间。
在开发者预览阶段,该功能默认关闭,需要通过注册表配置和测试签名启用;启用测试签名还可能需要暂时关闭 Secure Boot。微软因此建议用户在专用开发设备而非日常使用的电脑上进行测试。
尽管正式普及时间尚不确定,这项技术若最终落地,可能让强大的本地 AI 推理变得更加普及。开发者或可不再必须购买昂贵专用 AI 服务器,而是将多台现有 PC 的内存和 GPU 资源组合起来,运行更大规模的本地 AI 模型。